
NOTE
1.1 时序数据库
时序数据库、时序数据、数据模型与存储实现。
这是历史学习笔记,可能存在过时或不完整的理解。
1. 什么是时序数据库
专门为timestamp或者time series data优化的数据库 时序数据库专门针对持续产生、带时间戳的数据做写入、压缩、聚合和时间范围查询优化。关系型数据库也可以保存历史数据,这里的差异主要在于数据模型与面向时序工作负载的优化。
2. 什么是时序数据
时序数据是基于时间的一系列的数据
3. 为什么需要时序数据库
3.1. 关系模型记录
- 如果用数据库记录时序数据如下:
- 缺点:
- 写入:数据量大,
- 查询:根据时间聚合效率低
- 成本:成本高
3.2. 时序模型记录
-
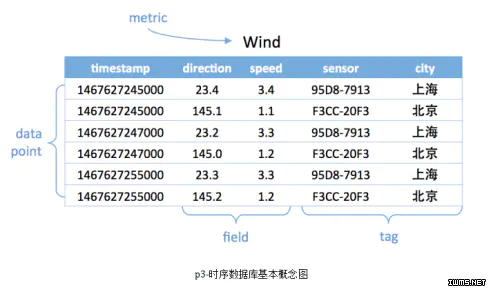
metric:指标名,当前数据的标识。在部分 TSDB(如 InfluxDB 的历史模型)中,可以类比关系型数据库中的 table;不同 TSDB 的术语并不完全相同。
-
data point: 数据点。相当于关系型数据库中的row。
-
timestamp:时间戳。代表数据点产生的时间。
-
field: metric下的不同字段。一般情况下存放的是会随着时间戳的变化而变化的属性信息。比如位置这个metric具有经度和纬度两个field。
-
tag: 标签,或者附加信息。一般存放的是并不随着时间戳变化的属性信息。timestamp加上所有的tags可以认为是table的primary key。
-
上面的例子中
- 度量为Wind,每一个数据点都具有一个timestamp
- 两个field:direction和speed
- 两个tag:sensor、city。它的第一行和第三行,存放的都是sensor号码为95D8-7913的设备,属性城市是上海。随着时间的变化,风向和风速都发生了改变,风向从23.4变成23.2;而风速从3.4变成了3.3。
4. 时序数据库实现
4.1. LSM Tree
LSM.md
4.2. 分布式存储
当时序数据规模超过单机容量或吞吐能力时,可以采用多机分布式存储;小规模场景并不要求一定使用分布式部署。
4.2.1. 分布算法
分布式系统分区.md
4.2.2. 分片key
metric+tags分片 因为往往会按照一个时间范围查询,这样相同metric和tags的数据会分配到一台机器上连续存放,顺序的磁盘读取是很快的